Blog
Ultime novità su AI, agenti e nuove tecnologie
Approfondimenti pragmatici su LLM, agenti autonomi, hardware e standard emergenti. Quello che conta davvero per chi costruisce prodotti AI oggi.
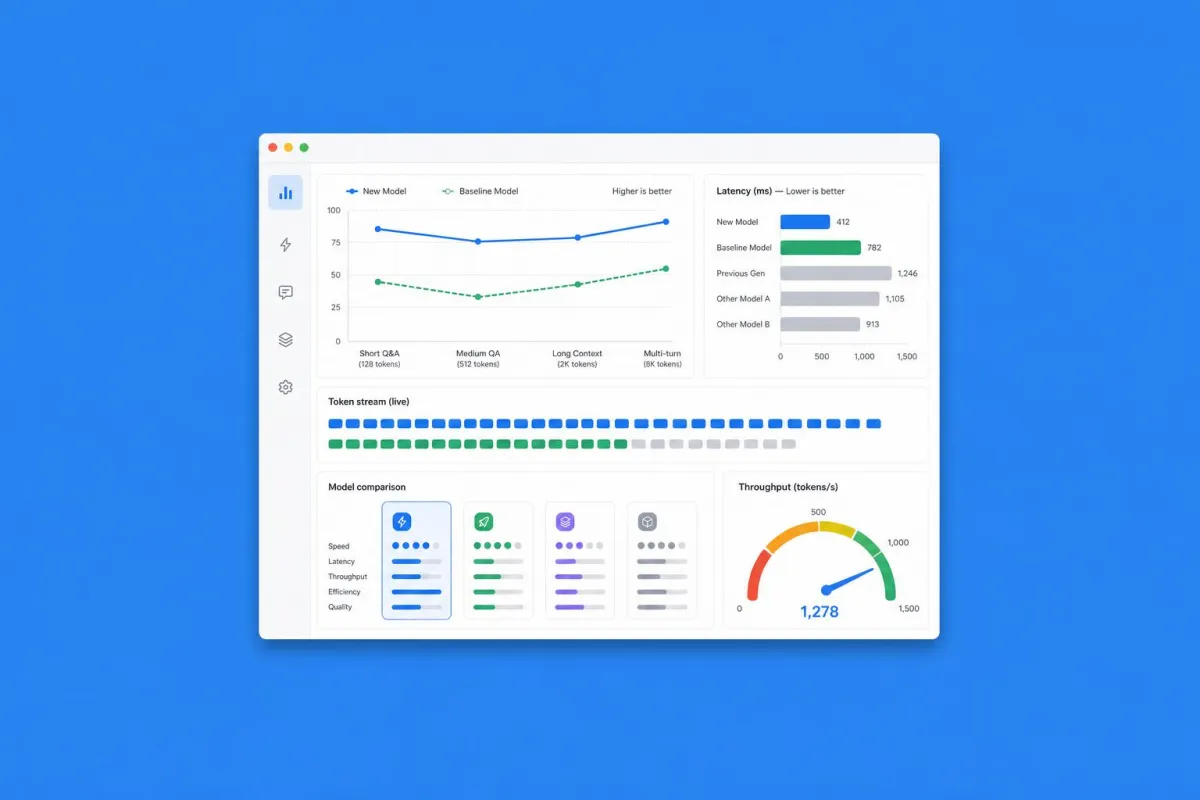
Gemma 4 diventa 3x più veloce grazie a MTP
Con Multi-Token Prediction Gemma 4 triplica la velocità di inferenza senza perdere qualità. Cosa cambia per chi sceglie modelli open-weight in produzione.
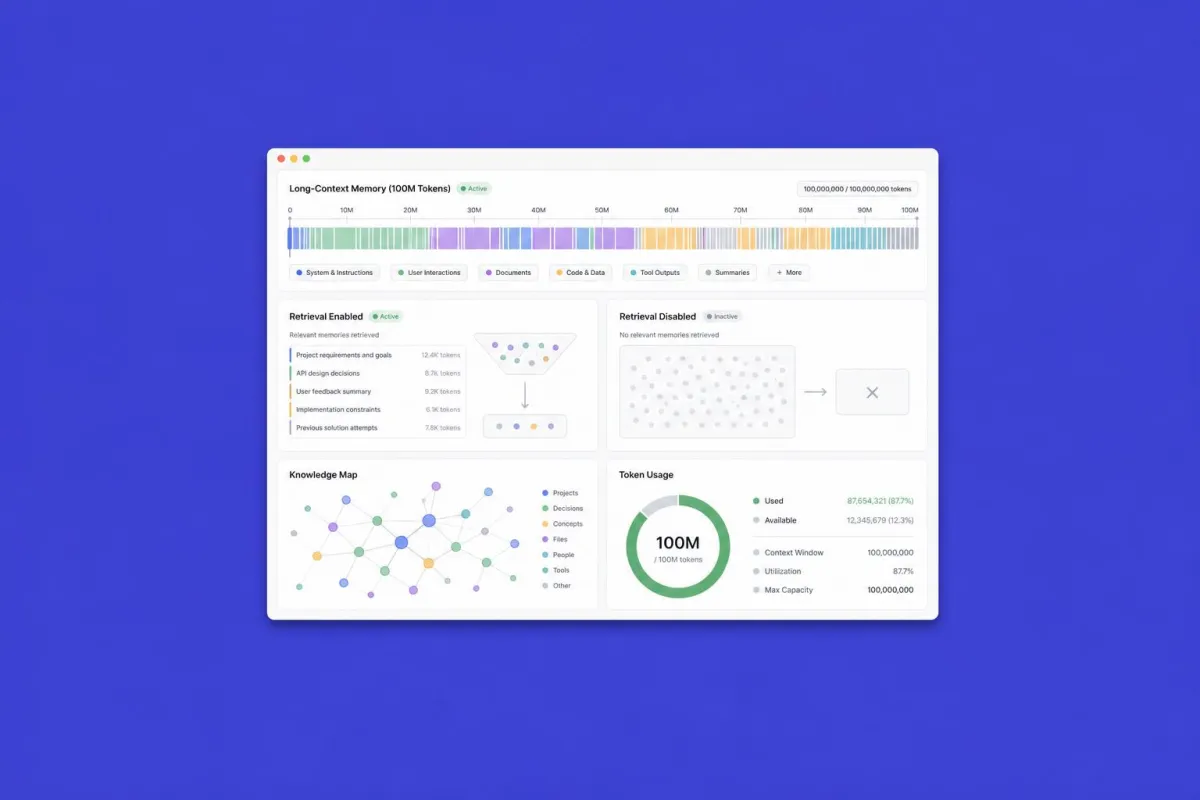
AI con 100M token di memoria: è la fine del RAG?
Le finestre di contesto da 100M token cambiano il gioco, ma non eliminano il RAG. Quando conviene davvero abbandonare le pipeline di retrieval e quando no.
Anthropic × SpaceX: nuovi record per Claude
Grazie a Starlink e ai data center orbitali sperimentali, Anthropic alza i limiti di Claude di un ordine di grandezza.
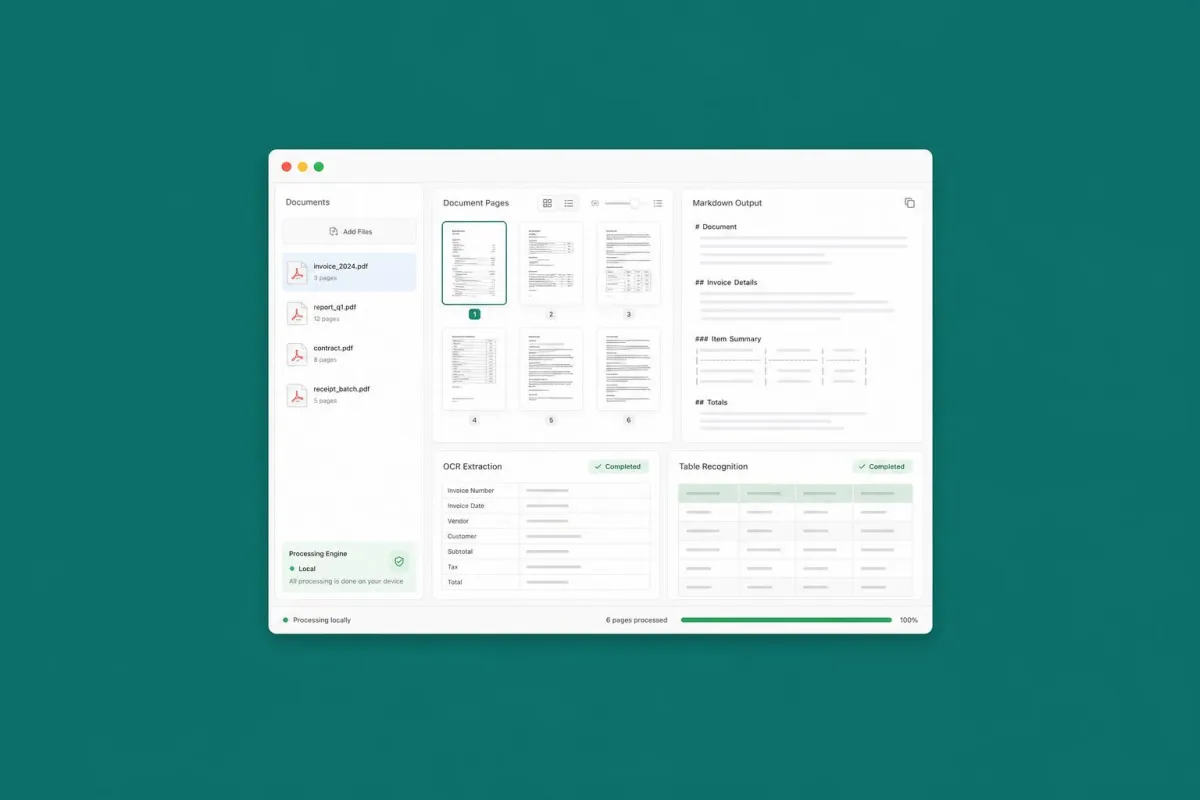
GLM-OCR in locale: PDF in Markdown senza cloud
Estrarre testo da PDF complessi mantenendo struttura e gerarchia, senza inviare nulla a server esterni. Cosa cambia per chi gestisce documenti riservati.
Dreaming: gli LLM che 'sognano' soluzioni da inattivi
Un nuovo paradigma per gli agenti autonomi: il modello continua a ragionare in background quando non riceve input, esplorando soluzioni in modo non lineare.
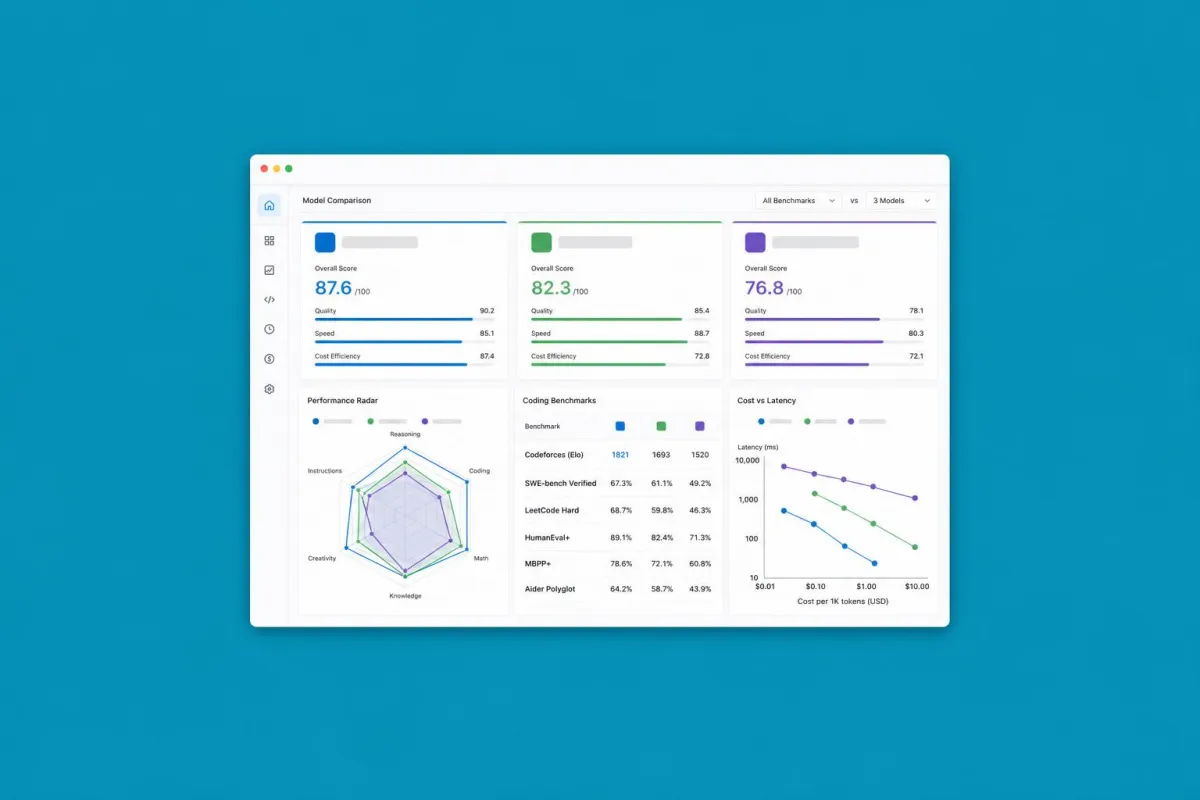
DeepSeek V4 vs GPT-5.5 e Opus 4.8: chi vince?
DeepSeek V4 arriva con benchmark da top tier ed è open-weight. Cosa succede quando lo si confronta su task reali con GPT-5.5 e Claude Opus 4.8.
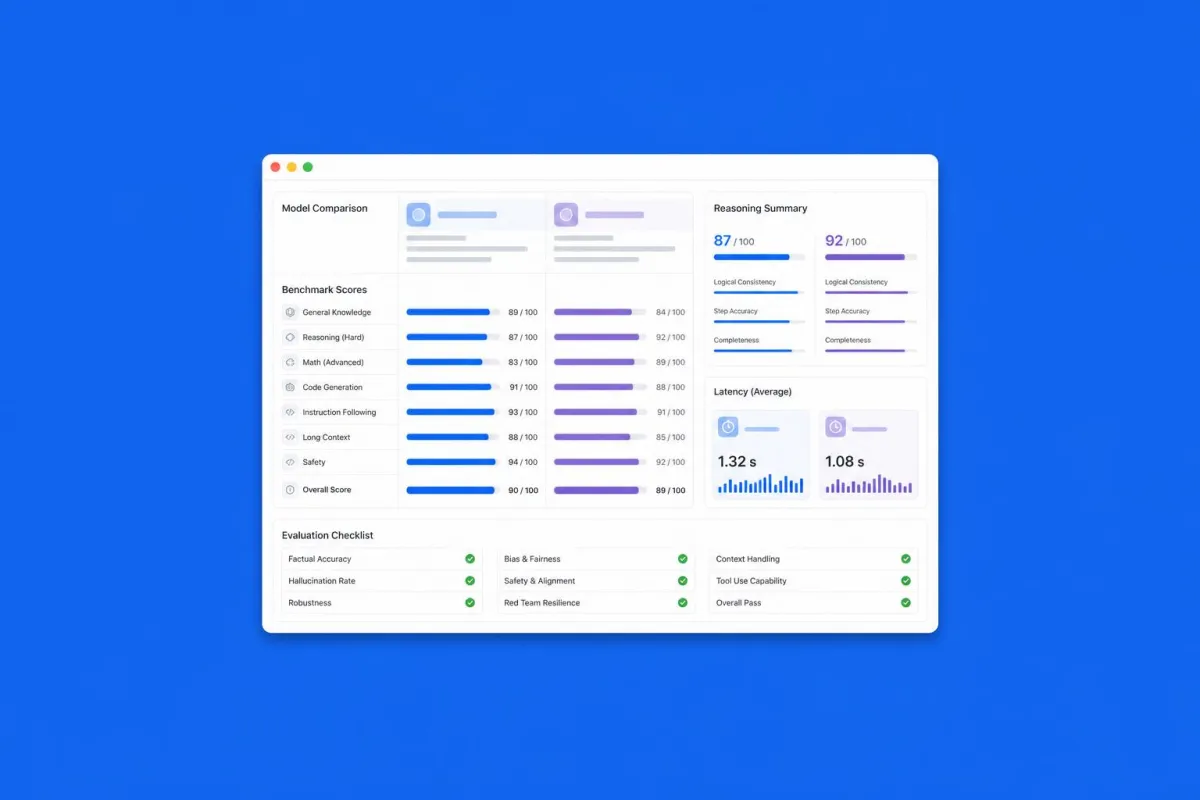
GPT-5.5 batte Opus 4.8? La verità dopo i test
Tra entusiasmo e scetticismo, la verità sta nel mezzo: dove GPT-5.5 fa davvero un passo avanti e dove Opus 4.8 mantiene il suo margine.
RAG è già vecchio? Knowledge Base con LLM Wiki
Il RAG non è morto, ma il modo di strutturare la conoscenza sta evolvendo. LLM Wiki costruisce knowledge base con relazioni esplicite e meno allucinazioni.
Claude Design: perché tutti ne stanno parlando
Non è solo generazione grafica: Claude Design capisce l'intenzione dietro una richiesta di design e abbassa la barriera per chi non è progettista visivo.
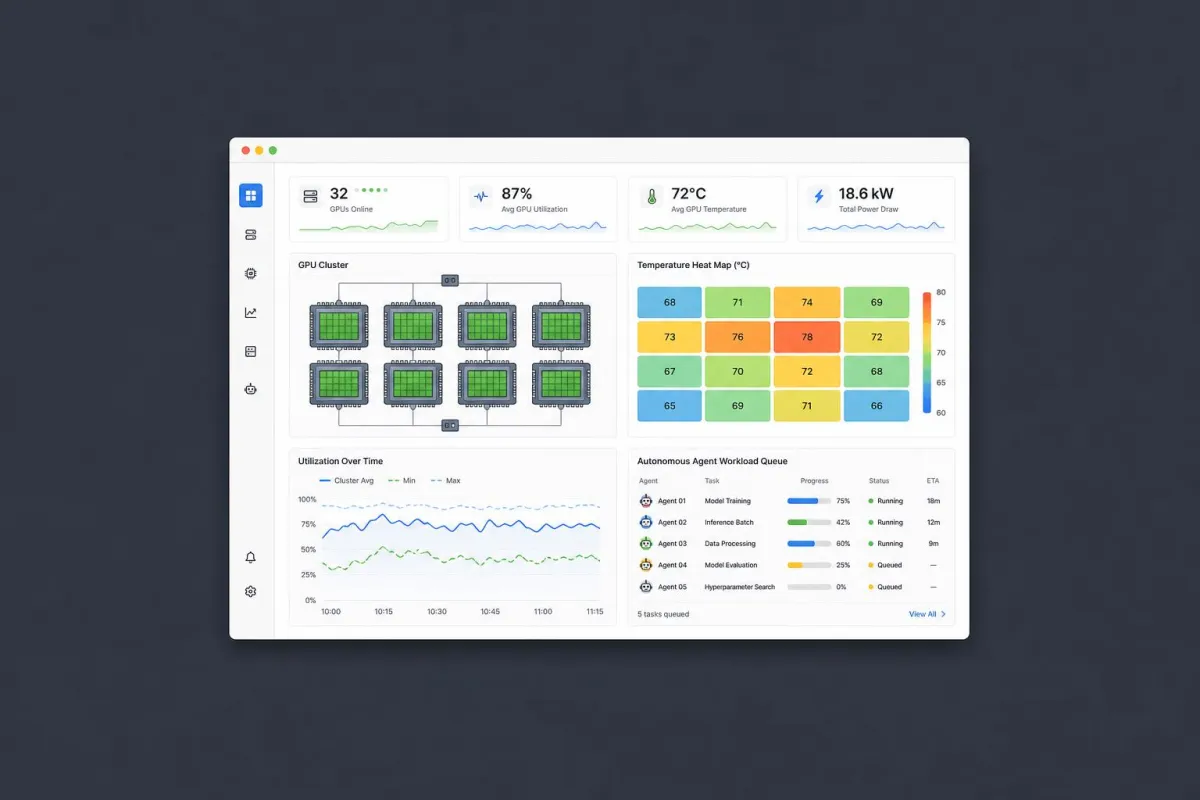
NVIDIA Blackwell Ultra: GPU per agenti autonomi
La nuova architettura Blackwell Ultra triplica il throughput su workload agentici e introduce primitive hardware dedicate al tool calling.
Claude Opus 4.8: il nuovo riferimento per il coding AI?
Coerenza su codebase grandi e debugging autonomo: cosa cambia davvero per i team di sviluppo che adottano Opus 4.8 in produzione.
Risparmia il 75% dei token e rendi l'AI 3x più veloce
Meno token significa meno costi, ma soprattutto meno latenza. La tecnica per costruire prompt e contesti chirurgici senza perdere qualità.